Schema Markup für GEO: Welche strukturierten Daten KI-Systeme bevorzugen
Welche Schema-Typen für GEO wirklich zählen, wie du sie implementierst und was Google seit 2026 offiziell zu strukturierten Daten und KI-Suche sagt.
Ein Bild, das ich beim Prüfen von Websites schon mehrfach gesehen habe: eine gepflegte Website, ordentlicher Content, und im Quellcode herrscht Funkstille. Kein Article-Schema, kein Autor, nichts, was einer Maschine sagt, womit sie es zu tun hat.
Dabei ist Schema Markup eine der dankbarsten Maßnahmen überhaupt: einmal sauber aufgesetzt, wirkt es dauerhaft, kostet nichts und erfordert keine Redaktion. Es ist allerdings kein Geheimtrick für die KI-Suche, dazu gleich mehr. Ein Nachmittag Arbeit, wenn man weiß, was man tut. Dieser Artikel sorgt dafür, dass du es weißt.
Worum es geht
Schema Markup (strukturierte Daten) ist maschinenlesbarer Code nach dem Standard von schema.org, der Suchmaschinen und KI-Systemen explizit mitteilt, was ein Inhalt bedeutet, nicht nur, was er sagt.
Ein Mensch erkennt aus dem Kontext, dass “Yassine Oulada” der Autor dieses Artikels ist. Eine Maschine muss das erschließen, und Erschließen heißt: Sie kann sich irren. Schema Markup macht aus der Vermutung eine Angabe: "@type": "Person", "name": "Yassine Oulada". Eindeutig, verlässlich, sofort verwertbar.
Was Google seit 2026 offiziell dazu sagt
Im Mai 2026 hat Google einen Leitfaden zur Optimierung für die KI-Suche veröffentlicht, und der räumt mit einem verbreiteten Mythos auf: Für AI Overviews und AI Mode sind strukturierte Daten nicht erforderlich, und es gibt kein spezielles Schema für KI-Funktionen. Google versteht Inhalte auch ohne Markup. Wer dir “KI-Schema” als Abkürzung in die AI Overviews verkauft, verkauft dir also etwas, das es nicht gibt.
Warum ich Schema Markup trotzdem für sinnvoll halte, aus drei Gründen:
- Eindeutigkeit. Autor, Datum, Organisation: Was im Markup steht, muss niemand erraten. Gerade für E-E-A-T-Signale wie Autorschaft ist das wertvoll.
- Rich Results. Google empfiehlt strukturierte Daten weiterhin ausdrücklich für Rich Results in der normalen Suche, und die normale Suche ist das Fundament der KI-Suche.
- Andere Systeme. Wie ChatGPT, Perplexity oder Copilot mit strukturierten Daten umgehen, ist nicht offiziell dokumentiert. Schaden tut sauberes Markup dort nicht.
Kurz: Schema Markup ist gute Hygiene mit klarem Nutzen, aber kein Hebel, der allein über KI-Sichtbarkeit entscheidet. Mit dieser Erwartung lohnt es sich.
Die sechs Typen, die zählen
schema.org kennt hunderte Typen. Für Blogs und B2B-Websites brauchst du sechs.
Article / BlogPosting
Die Basis für jede Content-Seite. Ohne dieses Schema fehlen einer Maschine so grundlegende Dinge wie das Publikationsdatum, und Aktualität ist ein Auswahlkriterium.
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Schema Markup für GEO",
  "datePublished": "2026-07-04",
  "author": { "@type": "Person", "name": "Yassine Oulada" }
}
Person
Mein Favorit, weil hier E-E-A-T maschinenlesbar wird. Das unterschätzte Feld ist sameAs: Es verknüpft die Autorenidentität mit externen Profilen, sodass KI-Systeme Autoritätssignale aus mehreren Quellen zusammenführen können.
{
  "@type": "Person",
  "name": "Yassine Oulada",
  "jobTitle": "GEO & SEO Spezialist",
  "url": "https://simplygeo.de/about",
  "sameAs": ["https://www.linkedin.com/in/yassine-o-726988196/"]
}
Ein Autor, der nur auf der eigenen Website existiert, ist ein schwaches Signal. Ein Autor mit konsistentem LinkedIn-Profil, Erwähnungen und sameAs-Verknüpfung ist ein starkes.
FAQPage
Fertige Frage-Antwort-Paare, maschinenlesbar ausgezeichnet. Aber Achtung, hier hat sich 2026 einiges getan: Seit Mai 2026 zeigt Google gar keine FAQ-Rich-Results mehr an, die aufklappbaren Fragen unter dem Suchergebnis sind Geschichte. Das Markup schadet nicht und kann anderen Systemen die Struktur verdeutlichen. Der eigentliche Wert liegt aber in der FAQ-Sektion selbst: klare Fragen, direkte Antworten, sichtbar auf der Seite.
{
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "Was ist GEO?",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "GEO steht für Generative Engine Optimization..."
    }
  }]
}
Wichtig: Die Antwort im Schema muss identisch mit dem sichtbaren Text auf der Seite sein. Diskrepanzen zwischen Markup und Inhalt gelten als Manipulation, dazu gleich mehr.
HowTo, Organization, BreadcrumbList
Die restlichen drei in Kurzform: HowTo strukturiert Anleitungen in nummerierte Schritte. Rich Results dafür zeigt Google seit 2023 nicht mehr an, sinnvoll bleibt vor allem die klare Schrittstruktur im sichtbaren Text. Organization gehört auf die Startseite und gibt Unternehmenskontext. BreadcrumbList hilft Maschinen, die Seitenhierarchie zu verstehen, also welche Inhalte thematisch zusammengehören.
Implementierung: nimm JSON-LD, fertig
Es gibt drei Formate für strukturierte Daten, und die Entscheidung ist einfach: JSON-LD. Es wird von Google explizit bevorzugt, lebt als eigener <script type="application/ld+json">-Block getrennt vom HTML und lässt sich dadurch pflegen, ohne das Layout anzufassen. Microdata und RDFa verweben sich mit dem HTML und werden bei jedem Redesign zur Stolperfalle. Mir fällt kein Szenario ein, in dem sie heute noch die bessere Wahl wären.
Die fünf häufigsten Fehler
Aus Erfahrungsberichten, SEO-Studien und dem, was ich bisher selbst geprüft habe, ergibt sich eine ziemlich stabile Top 5:
- Kein Person-Schema. Ein Klassiker. Der Content hat einen Autor, der Code weiß nichts davon. E-E-A-T verpufft.
- Falsches oder fehlendes Datum.
datePublishedfehlt oder wird bei jeder Kleinständerung überschrieben. Beides schadet: Ohne Datum keine Aktualitätsbewertung, mit ständig “frischem” Datum kein Vertrauen. - Schema widerspricht dem Seiteninhalt. Markup mit Angaben, die nirgends auf der Seite stehen, wird von Google als Spam gewertet. Im schlimmsten Fall gibt es eine manuelle Maßnahme.
- Kein
sameAs. Die Autorenidentität bleibt eine Insel. Gerade dieses Feld kostet zwei Minuten und bringt überproportional viel. - Schema nur auf der Startseite. Strukturierte Daten wirken pro Seite. Eine ausgezeichnete Startseite hilft dem Blogartikel nicht.
Prüfen, bevor es live geht
Zwei Tools, beide kostenlos: Der Schema Markup Validator prüft Syntax und Pflichtfelder, der Google Rich Results Test zeigt zusätzlich, ob das Markup für Rich Results qualifiziert. Google hat seit 2025 eine ganze Reihe von Rich-Result-Typen eingestellt, darunter im Mai 2026 die FAQ-Ergebnisse. Ein Blick in die offizielle Dokumentation lohnt sich deshalb, bevor du Zeit in einen Typ steckst. Ich validiere jeden Seitentyp einmal komplett, danach nur noch bei Änderungen.
Mein Rat
Fang nicht mit allen sechs Typen gleichzeitig an. Die Reihenfolge, nach der ich selbst vorgehe: erst Article plus Person auf allen Beiträgen, das ist der größte Hebel. Dann Organization auf die Startseite. FAQPage und der Rest kommen, sobald die passenden Inhalte existieren, mit realistischer Erwartung, denn sichtbare Rich Results gibt es dafür bei Google nicht mehr.
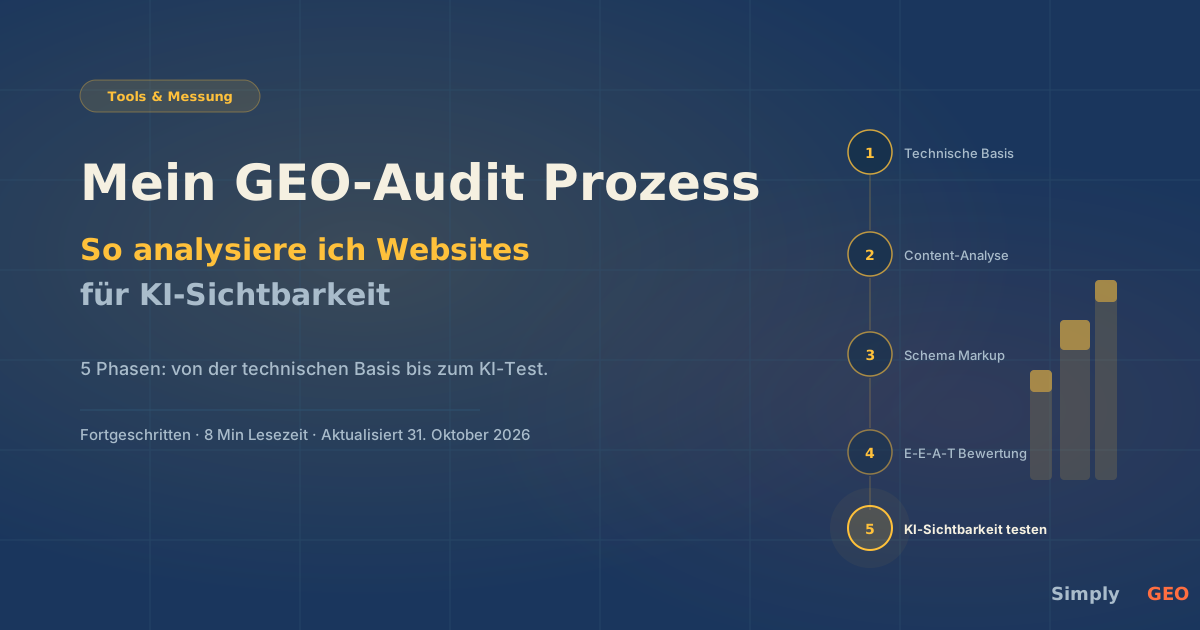
Und wenn du wissen willst, wie Schema Markup in den größeren Prüfkontext passt: Im GEO-Audit-Prozess ist es Phase 3 von 5.
Fragen, Ergänzungen oder Widerspruch?
Schreib mir gern, wenn du zu diesem Artikel etwas loswerden willst. Ich freue mich über Rückfragen, eigene Erfahrungen und auch über Hinweise, wenn ich etwas übersehen habe.